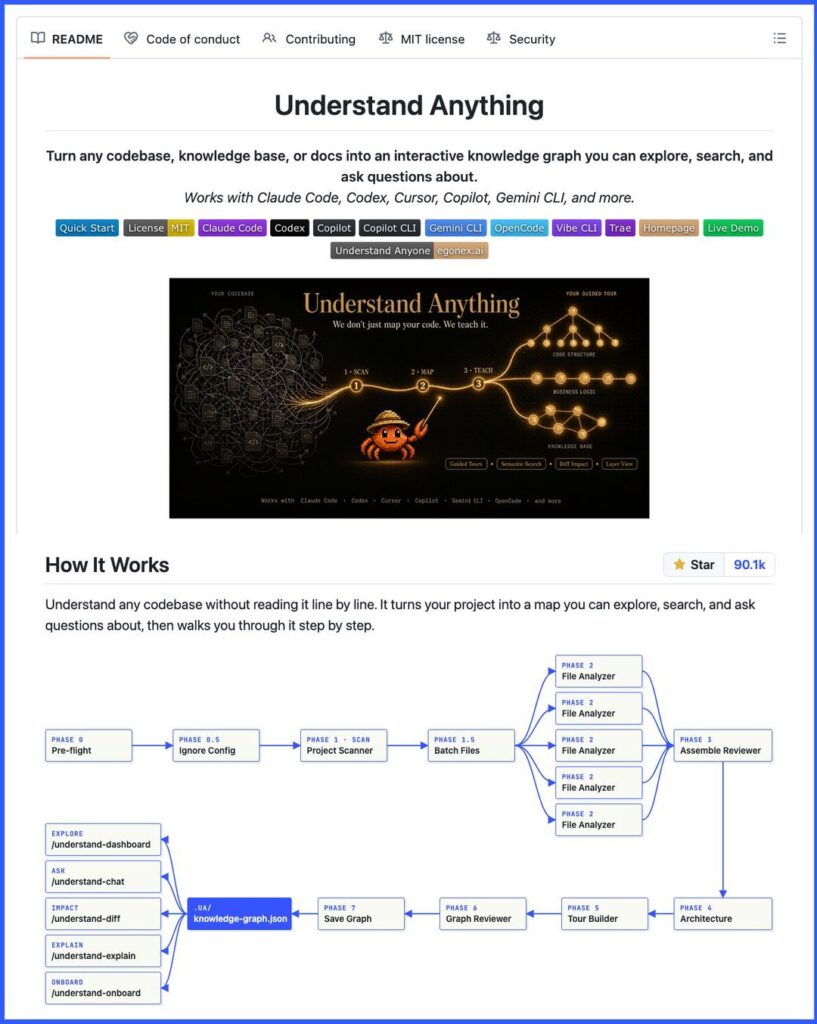
Tengo 99 repositorios indexados en un grafo para que mis agentes trabajen con información y no a oscuras. Esta semana GitHub ha dado justo en esa tecla.
Para entender un repositorio no hace falta leérselo entero
Cuatro repos que me quedo:
1. Understand-Anything (92K estrellas)
Transforma cualquier base de código en un grafo navegable al que puedes hacerle preguntas directamente. Compatible con Claude Code, Codex y Cursor.
2. llm-engineer-toolkit (11K estrellas)
Más de 120 librerías de LLM agrupadas por función: entrenamiento, RAG, agentes, evaluación. Se acabó perder el tiempo buscando sin rumbo.
3. auto-ontology (11K estrellas)
Desarrollado por NVIDIA. Añade una capa semántica sobre tus datos para que el agente entienda qué significa un término como «ingresos» en cada sistema antes de ponerse a escribir SQL.
4. FreeToken (17K estrellas)
Permite ejecutar modelos MoE de gran tamaño en un PC de gaming distribuyendo la carga entre GPU y CPU en función de lo que requiere cada token.
El modelo ya sabe programar. Lo que le falta es contexto.
¿Cómo se lo proporcionas tú a tu agente?
Los enlaces están en el primer comentario.
4 repositorios para dar contexto estructurado a agentes de IA en 2025
Resumen técnico
El post identifica cuatro repositorios críticos para gestión de contexto en agentes LLM. Understand-Anything (92K estrellas) convierte codebases en grafos consultables compatibles con Claude Code, Codex y Cursor. llm-engineer-toolkit (11K estrellas) cataloga más de 120 librerías organizadas por caso de uso: entrenamiento, RAG, agentes y evaluación. auto-ontology (11K estrellas), desarrollado por NVIDIA, genera capas semánticas sobre fuentes de datos heterogéneas. FreeToken (17K estrellas) distribuye inferencia de modelos MoE entre GPU y CPU dinámicamente por token, permitiendo ejecutar modelos grandes en hardware consumer.
Análisis de implicaciones
El problema central no es la capacidad del modelo sino la calidad del contexto inyectado. Representar un codebase como grafo en lugar de texto plano permite navegación semántica y consultas estructuradas, reduciendo alucinaciones en tareas de razonamiento sobre código. auto-ontology resuelve la ambigüedad léxica entre sistemas: un agente que entiende que ingresos tiene definiciones distintas en cada base de datos evita errores silenciosos en generación de SQL. FreeToken democratiza la inferencia de modelos MoE eliminando la restricción de VRAM exclusiva.
Aplicación práctica
Understand-Anything se integra directamente en flujos con Cursor o Claude Code: indexas el repositorio, generas el grafo y el agente consulta dependencias sin leer archivos completos. Con auto-ontology defines un esquema semántico centralizado que el agente consulta antes de generar cualquier query sobre datos de negocio. llm-engineer-toolkit funciona como referencia de selección de stack: dado un requisito, identifica qué librería cubre evaluación, orquestación o fine-tuning sin búsqueda manual. FreeToken permite ejecutar modelos MoE de 70B+ en setups con GPU + RAM del sistema.
Contexto del sector
El foco del ecosistema LLM se ha desplazado de escalar parámetros a optimizar el contexto operativo del agente. Herramientas como LlamaIndex o LangChain abordan RAG genérico, pero la tendencia actual apunta a representaciones especializadas: grafos de código, ontologías de dominio y distribución eficiente de inferencia. FreeToken y auto-ontology son señales claras de que tanto NVIDIA como la comunidad priorizan accesibilidad y precisión semántica frente a potencia bruta.


