
Qué es Jev y para qué sirve
Toca aclarar de una vez qué es Jev. La versión corta: es un “IF as a Service”. Ba dum tss 🥁
Ahora, en serio. Cuando empleamos un LLM para clasificar o enrutar información, lo que obtenemos es texto. Después hay que transformar ese resultado en un JSON, parsearlo, validarlo y cruzar los dedos para que todo salga bien. Y todo ese proceso existe únicamente para alimentar una simple decisión condicional en nuestro código.
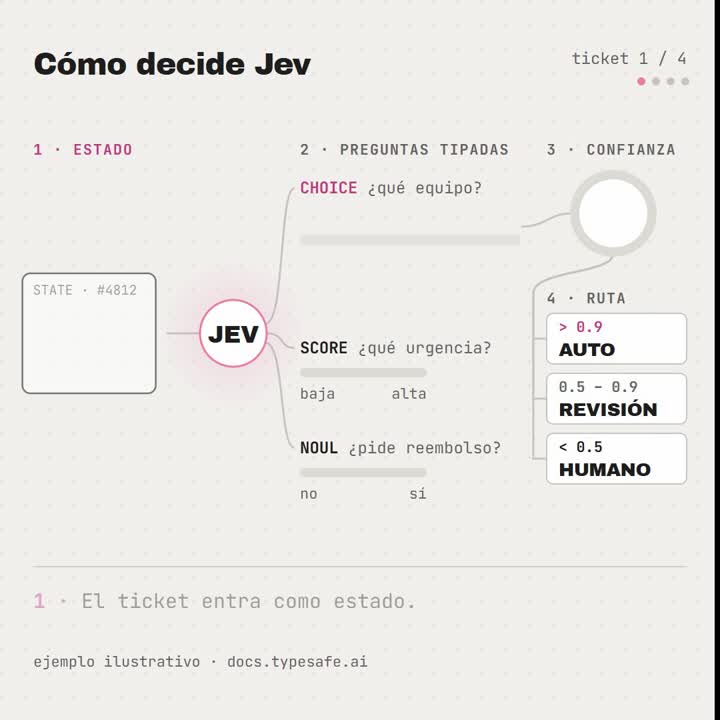
Jev funciona de otra manera: en lugar de generar texto, tú le defines las categorías y él te devuelve una probabilidad para cada una, directamente lista para que tu código la consuma y tome decisiones.
¿Por qué merece la pena?
- Sin parsing: la salida siempre respeta la estructura que tú has definido.
- Coste: 0,042 dólares por millón de tokens de entrada, y los de salida son gratuitos.
- Velocidad: al no escribir token por token, las respuestas llegan en milisegundos.
- Umbrales: si la confianza es elevada, puedes automatizar; si es baja, delegas a un LLM o a una persona.
Cuando se trata de orquestar agentes o manejar un gran número de categorías, la diferencia de consumo de tokens respecto a un LLM convencional es considerable.
Eso sí, que sea un buen clasificador no implica que acierte siempre. Su contexto es limitado, pierde precisión cuando le introduces información irrelevante y no destaca en tareas de cálculo o aritmética. El razonamiento complejo sigue siendo terreno de los LLM.
Jev se lanzó el 15 de septiembre. Apenas dos semanas más tarde, OpenAI presentó su Decisions API en el DevDay, y ya han aparecido alternativas de código abierto como Kev que, según los benchmarks, no se alejan demasiado en calidad.
Jev: clasificación probabilística sin parsing como servicio de inferencia condicional
Resumen técnico
Jev es un servicio de clasificación que devuelve distribuciones de probabilidad por categoría, eliminando el ciclo de generación de texto, extracción de JSON y validación típico de los LLM. El coste de entrada es $0,042 por millón de tokens, con tokens de salida gratuitos. La latencia es de orden de milisegundos al no generar secuencias token a token. Permite definir umbrales de confianza para bifurcar entre automatización completa y escalado a un LLM o agente humano. Lanzado el 15 de septiembre, semanas antes de que OpenAI presentase su Decisions API en el DevDay. Existen alternativas open source como Kev con resultados comparables en benchmarks.
Análisis de implicaciones
El cambio principal es estructural: el output deja de ser texto no determinista para convertirse en un vector de probabilidades con forma fija. Esto elimina capas de procesamiento frágil en pipelines de orquestación de agentes. El modelo tiene contexto limitado, degrada precisión con información irrelevante y no ejecuta aritmética ni razonamiento complejo, por lo que no reemplaza a un LLM en tareas de comprensión profunda. Su función es específicamente el ruteo y la clasificación a escala, donde la relación coste-latencia justifica separarlo del modelo generativo principal.
Aplicación práctica
En un pipeline de atención al cliente, Jev recibe el texto del usuario y devuelve probabilidades sobre categorías como facturación, soporte técnico o baja. Si la probabilidad máxima supera el umbral definido, el sistema enruta automáticamente. Si no, escala a un LLM con contexto completo o a un agente humano. En orquestación multi-agente, sustituye llamadas completas a modelos generativos en nodos de decisión, reduciendo el consumo de tokens de forma significativa cuando el grafo contiene decenas de categorías.
Contexto del sector
La aparición de la Decisions API de OpenAI días después del lanzamiento de Jev confirma que la clasificación estructurada es una capa diferenciada dentro de los stacks de IA. La alternativa open source Kev introduce presión competitiva inmediata. El patrón de separar inferencia condicional de generación de texto se consolida como práctica de arquitectura en sistemas de agentes, reduciendo costes operativos en pipelines donde el ruteo representa la mayoría de las llamadas.


