RAG lineal, adaptativo o agéntico: ¿cuál necesitas realmente?
Si tu sistema RAG lanza una búsqueda en la base vectorial cada vez que alguien escribe «gracias», estás ante un RAG lineal sin más. La elección entre las tres variantes depende de dos factores: cuántas consultas realmente requieren documentos y cuántas búsquedas necesita cada una de ellas.
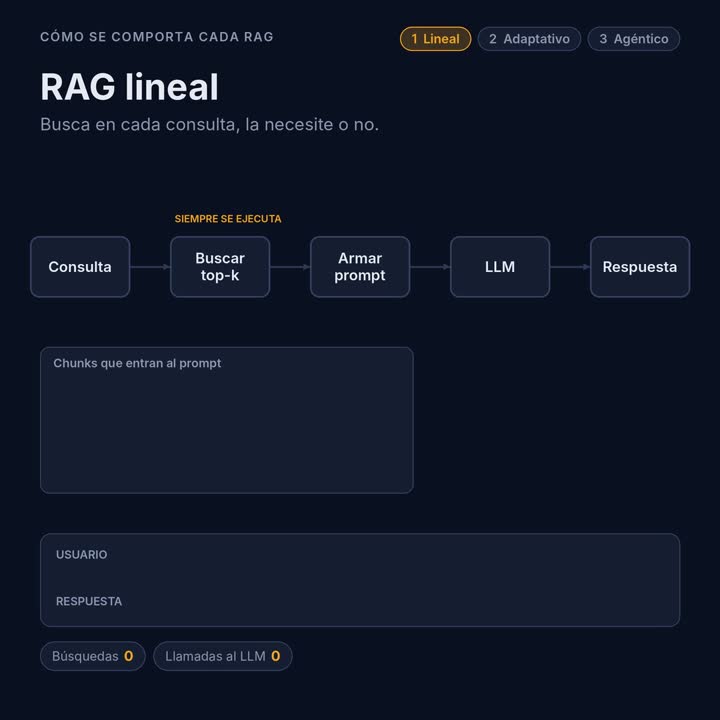
RAG lineal. Con cada consulta, el sistema recupera los top-k chunks y los incluye directamente en el prompt, independientemente de si el usuario está pidiendo información o simplemente saludando. El resultado es que en cada turno pagas búsqueda y tokens de contexto, y los fragmentos irrelevantes generan ruido innecesario. Tiene sentido cuando prácticamente todas las consultas giran en torno a los documentos, como en un FAQ o un buscador de documentación técnica.
RAG adaptativo. Antes de buscar nada, un paso previo evalúa si la consulta realmente necesita contexto externo. Si lo necesita, busca y comprueba si los chunks recuperados son suficientes. Si no lo son, reformula la consulta y repite el proceso, siempre con un límite máximo de iteraciones. El flujo completo lo defines tú en el código. Es la opción adecuada cuando conviven consultas conversacionales con otras que sí requieren documentos.
Agentic RAG. Aquí el retrieval es una herramienta más del agente, al mismo nivel que una consulta SQL o una llamada a una API. Es el propio modelo quien decide si busca, qué busca y cuántas veces lo hace. Encaja bien con preguntas de varios saltos o que cruzan distintas fuentes. El precio a pagar: más llamadas al LLM, mayor latencia y una depuración bastante más compleja.
La distinción clave entre la segunda y la tercera opción es quién lleva el control del flujo: en el RAG adaptativo lo gobierna tu código; en el RAG agéntico, lo gobierna el modelo.
¿Con cuál empezasteis vosotros y qué os llevó a dar el salto al siguiente nivel?
RAG Lineal, Adaptativo y Agéntico: Cuándo Usar Cada Arquitectura
Resumen técnico
El RAG lineal ejecuta búsqueda vectorial en cada turno recuperando los top-k chunks sin discriminar intención, generando coste innecesario en tokens de contexto. El RAG adaptativo introduce un clasificador previo que decide si lanzar retrieval, con bucle de reformulación acotado por un máximo de iteraciones definido en código. El Agentic RAG expone el retrieval como una tool más junto a SQL o llamadas a APIs externas, delegando al modelo cuándo y cuántas veces buscar. La diferencia crítica: en adaptativo el flujo lo gobierna el código, en agéntico lo gobierna el LLM.
Análisis de implicaciones
El enfoque lineal introduce ruido semántico al inyectar chunks irrelevantes en el prompt, degradando la precisión de la respuesta y elevando el coste por llamada. El adaptativo reduce llamadas al índice vectorial en escenarios mixtos, pero exige lógica explícita de enrutamiento y criterios de suficiencia de contexto. El agéntico habilita razonamiento multi-salto y cruce de fuentes heterogéneas, a cambio de mayor latencia acumulada, costes de múltiples llamadas al LLM y trazabilidad más compleja en producción.
Aplicación práctica
Un FAQ corporativo o buscador de documentación técnica encaja con RAG lineal: casi el 100% de consultas requieren documentos. Un asistente conversacional con soporte técnico integrado se beneficia del adaptativo, clasificando intención antes de invocar el índice. Para análisis que cruzan una base vectorial, una base de datos SQL y una API REST externa, el agéntico es la opción natural, implementable con frameworks como LangGraph o LlamaIndex Workflows.
Contexto del sector
La adopción masiva de RAG en producción durante 2024 expuso los límites del enfoque lineal: costes operativos elevados y respuestas ruidosas en asistentes de propósito general. La evolución hacia arquitecturas agénticas se alinea con la consolidación de function calling en modelos como GPT-4o y Claude 3.5, que permiten razonamiento sobre herramientas con mayor fiabilidad que generaciones anteriores.